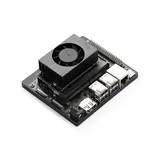
Si vas a correr modelos de IA en un Jetson Orin Nano, esto te ahorra horas: el límite práctico no son los 67 TOPS de cómputo, sino los 8GB de memoria unificada (de los que quedan ~5,2GB usables tras el sistema operativo) y el ancho de banda de memoria.
Para LLMs locales, el punto dulce está en modelos de 0,5B a 3B parámetros cuantizados (Q4). Gemma3-1B ronda los 40 tok/s; Llama-3.2-1B ~47 tok/s; modelos de 7B corren al límite de la RAM. Un detalle crítico que casi nadie documenta: en llama.cpp con CUDA necesitas GGML_CUDA_ENABLE_UNIFIED_MEMORY=1, o te dará un «out of memory» falso aunque tengas RAM libre.
Para visión en tiempo real, pasar de Python a C++ con TensorRT suele duplicar los FPS (YOLOv8n llega a 30+ FPS). Y para inferencia siempre activa, el modo de 25W es el óptimo (no el de 15W). Eso sí: bajo carga pesada el cooling activo es prácticamente obligatorio.
¿NVR multicámara con Frigate? Recuerda que el Orin Nano no tiene encoder de video por hardware (sí decoder), y conviene trabajar a 320×320 con 2+ cámaras para estabilidad.
Te contamos esto porque queremos que tu proyecto funcione, no solo venderte una placa. Si necesitas dimensionar tu caso (modelo, FPS, consumo), escríbenos.